부하테스트로 인프라 스펙을 확정해보자
파일럿 유치에 앞서 우리 시스템의 안정성을 테스트로서 보장해야했다. 게이트웨이부터 분석 서버, DB까지 총 14회차에 걸쳐 부하테스트를 진행했는데, 앞단 모듈부터 순차적으로 부하를 주며 아래 내용을 확인했다.
각 모듈은 어디까지 버티고, 그때 어떤 자원이 병목이 되는가?
모듈이 죽을 때까지 올리는 Breakpoint Test로 모듈별 한계와 취약 자원을 찾고, 그에 따라 개선을 붙이고, 목표 부하를 기준으로 스펙을 확정해나간 과정을 정리해보려 한다.
테스트 대상 서비스
테스트 대상은 게이트웨이, 분석 서버, DB 세 가지다.
먼저 서비스 아키텍처는 아래와 같다.
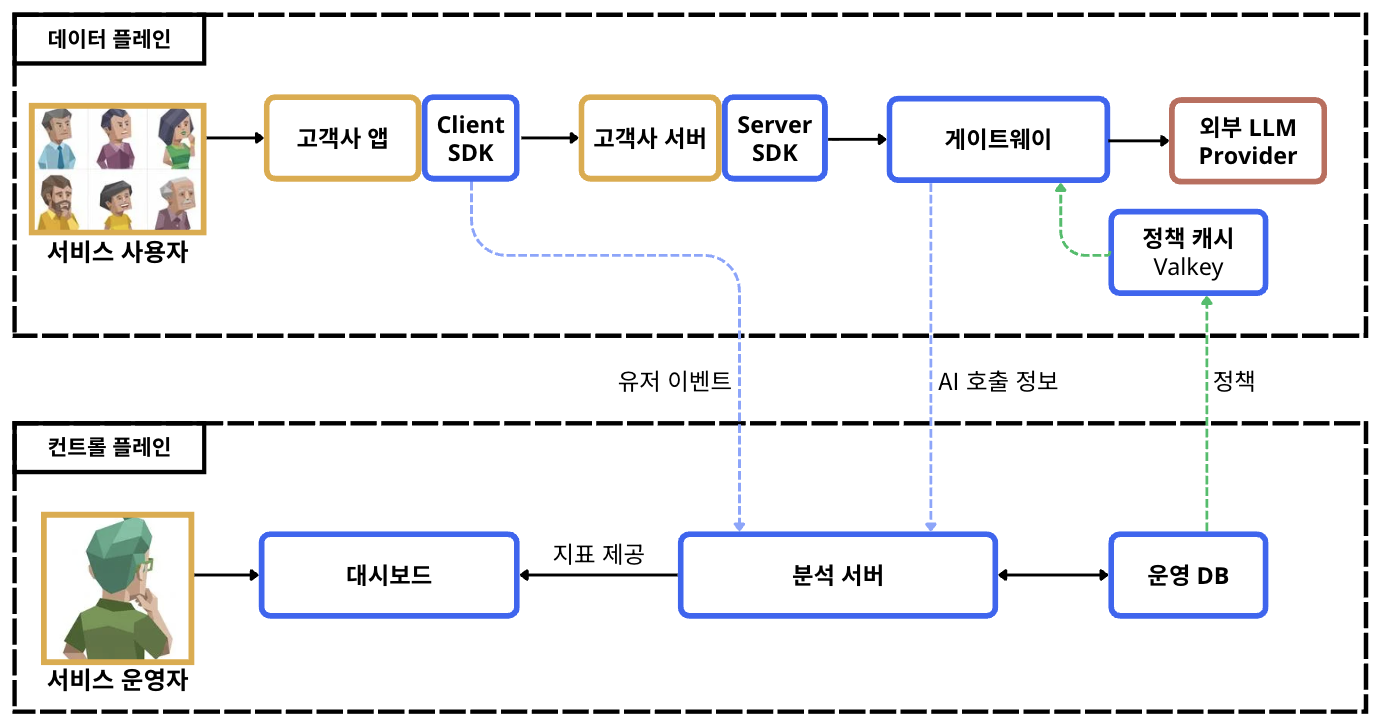
시스템은 크게 데이터 플레인과 컨트롤 플레인으로 나뉜다.
- 데이터 플레인: 고객사 엔드유저의 요청이 진행되는 부분으로, 고객사 앱/서버가 SDK를 통해 게이트웨이를 호출하면, 게이트웨이가 외부 LLM Provider로 요청을 중계한다. 이때 어떤 모델로 보낼지에 대한 정책은 Valkey에서 읽는다.
- 컨트롤 플레인: Client SDK의 유저 이벤트와 게이트웨이의 AI 호출 정보가 분석 서버로 모이고, 분석 서버는 운영 DB(PG)에 저장 후 집계해서 대시보드에 지표로 제공한다.
즉 부하 관점에서 보면, 엔드유저 트래픽은 게이트웨이에 직접 꽂히고, 그 트래픽만큼의 이벤트 인입이 분석 서버로 흘러들어오며, 최종적으로는 전부 DB에 쌓인다. 위 이유로 부하 테스트를 앞단 모듈부터 게이트웨이 -> 분석 서버 -> DB 순서로 진행했다.
이게 실제로 올라가 있는 AWS 인프라는 아래와 같다.
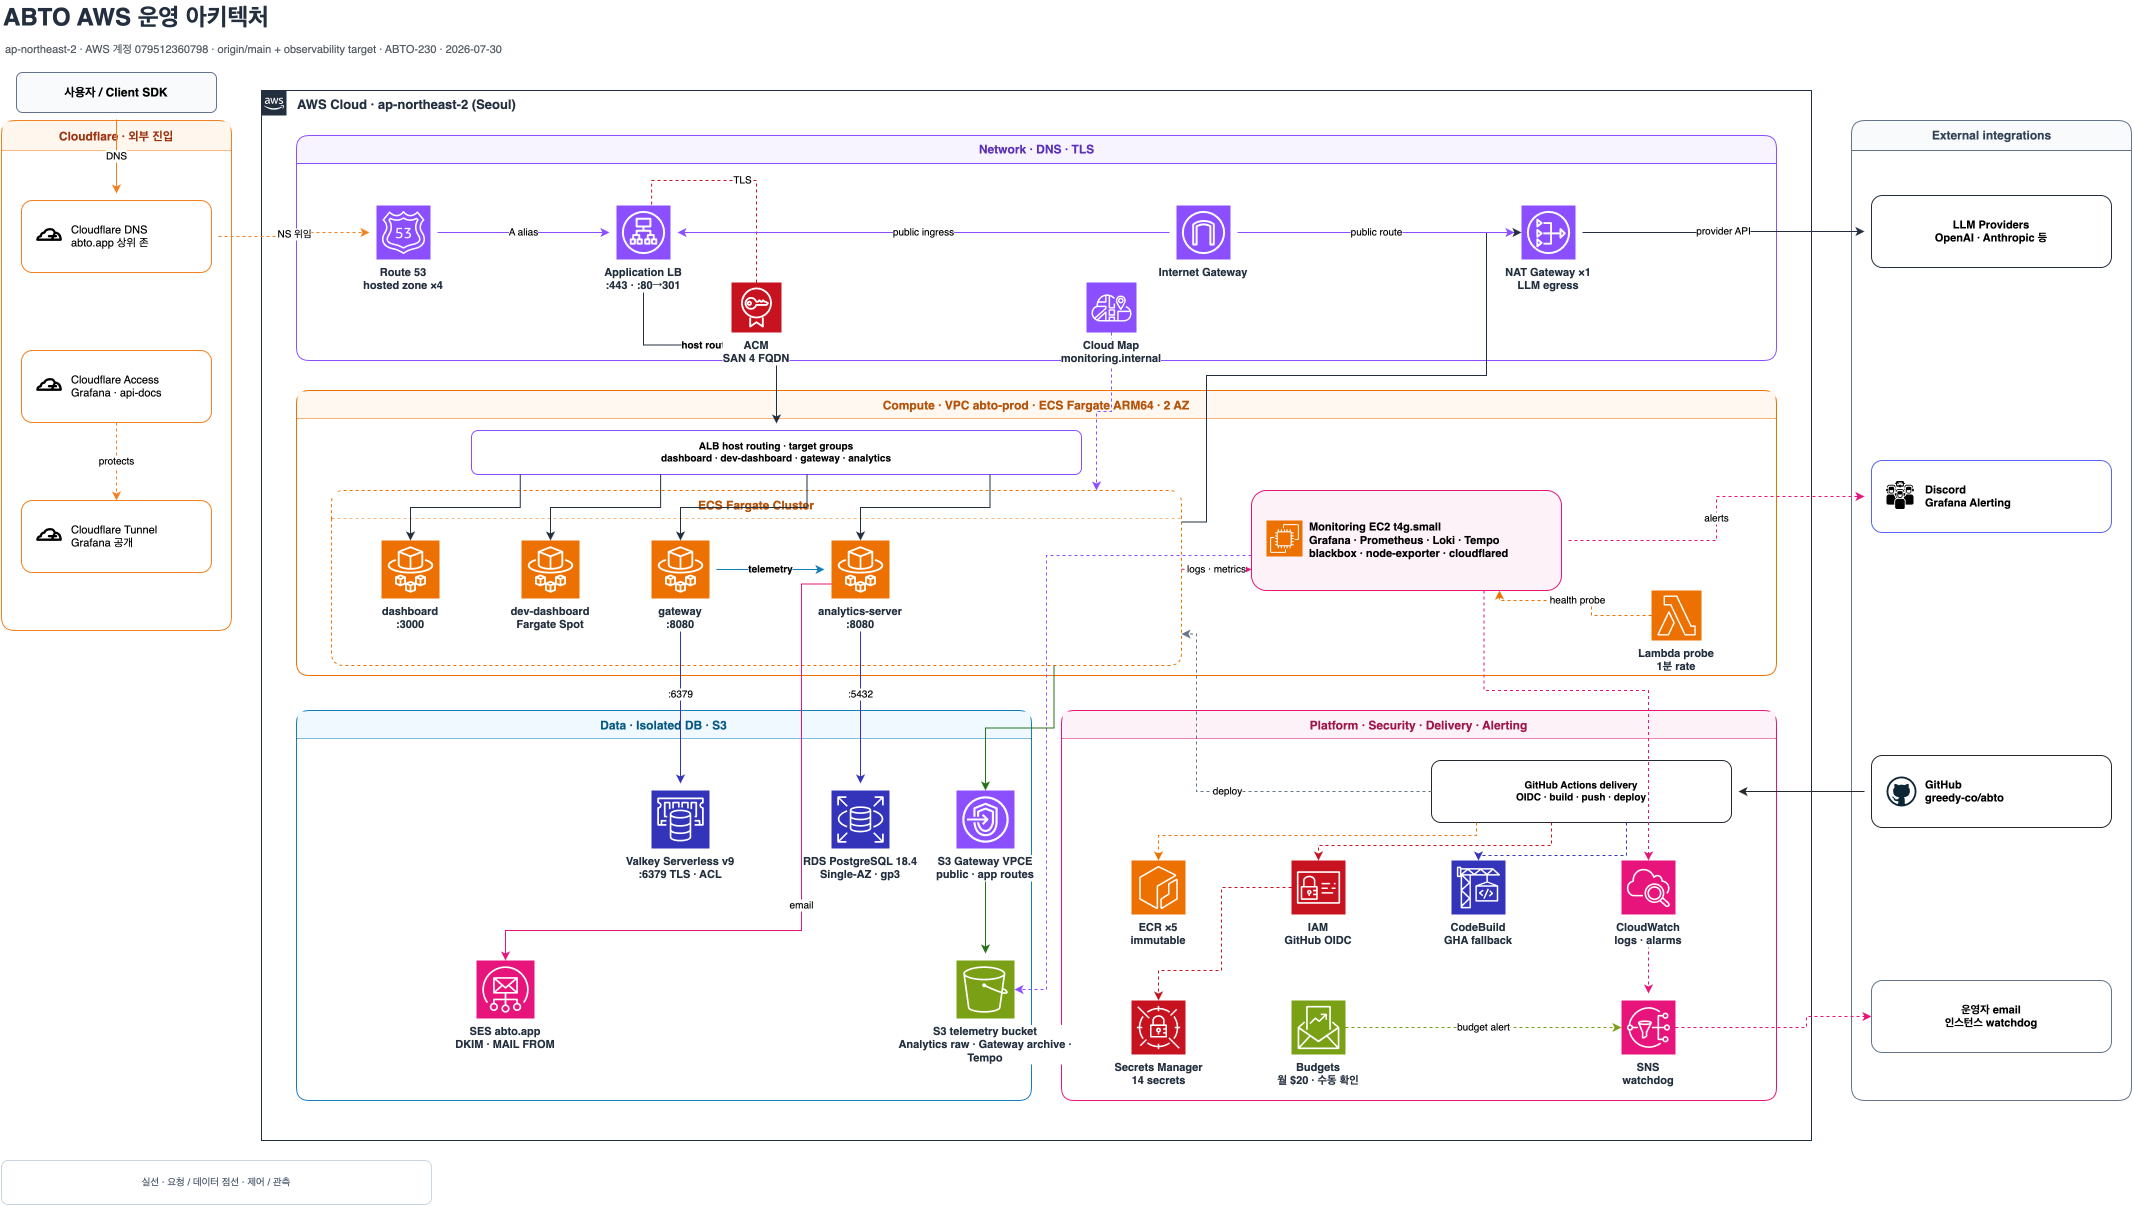
부하 테스트 관점에서 관련 있는 부분만 추려내면 아래와 같다.
- 게이트웨이와 분석 서버는 ECS Fargate(ARM64, 2 AZ) 위에서 돌고, ALB가 호스트 라우팅으로 트래픽을 나눠준다.
- DB는 RDS PostgreSQL 18 Single-AZ에 gp3 스토리지 구성이다.
- 모니터링은 별도 EC2의 Grafana + Prometheus + Loki로, 테스트 중 각 구간의 메트릭을 여기서 관측한다.
목표 부하
한계만 재서는 스펙이 안 나오기에, 이 정도를 버티면 통과라는 기준선, 목표를 아래 처럼 잡았다.
- 게이트웨이 피크 100 rps
- event 인입 1000 rps
지난 부하테스트 글과 같은 가정(활동 시간 8시간, 피크 배수 5배)에 인당 하루 10회 LLM 호출을 넣으면, 게이트웨이 100 rps는 DAU 약 57600에 해당한다. event 인입은 그 유저들이 만들어내는 유저 이벤트 합산으로, 호출의 10배인 1000 rps로 잡았다.
나이브하게 잡은 수치지만 MVP 단계에서는 이 정도면 충분하고, 이 선을 넘어설 때가 오면 그때는 메시지큐 도입이나 컬럼형 DB 마이그레이션 같은 구조 변경으로 넘어가야 할 시점이라 판단했다.
시작은 고객사 엔드유저와 가장 밀접하게 붙어 있는 게이트웨이부터 진행했다. 여기가 무너지면 고객사 서비스가 같이 무너지기에 가장 중요했다. 물론 SDK 단 Fallback이 존재하여 0이 되지는 않지만, 우리 서비스에서 가장 가용성이 보장되어야 할 모듈이다.
게이트웨이 Breakpoint Test
고객사 엔드유저의 LLM 호출이 직접 통과하는 모듈.
부하는 k6의 ramping-arrival-rate로 계단식으로 올렸고, 외부 LLM Provider는 mock 서버로 대체해서 지연 프로파일을 고정했다. 테스트는 로컬이 아닌 실제 운영 AWS 환경에서 진행했다.
최초 구성인 0.25 vCPU & 512 MB 태스크 1대의 결과는 아래와 같았다.
- 요청 서빙 자체는 74 rps까지 받았는데, 20 rps부터 고루틴 발송 텔레메트리가 새기 시작했다. 응답은 정상으로 나가는데 분석 서버로 보내는 발송 버퍼가 밀려서 조용히 드롭되는 것이었고, 유실률이 43.5%였다.
- 원인은 발송 워커가 1개뿐이라는 것이었고, 환경변수로 워커 개수를 조절 가능하게 변경하여 워커 개수를 8개로 늘리자 유실은 거의 사라졌는데 CPU가 새로운 취약 자원이 됐다. 태스크당 안정적인 처리는 50 rps선 이었고, 60 rps에서 느려지기 시작하고 70 rps에서 완료 처리량이 더 오르지 않았다
일부러 스트레스 테스트로 10 rps에서 80 rps로 급증 시켜보았더니 게이트웨이가 OOM으로 죽고 재기동한 태스크가 밀린 부하를 그대로 받아서 또 죽는 크래시 루프가 이어졌다.. 16분 동안 4번을 죽었다.
이게 오토스케일이 걸려있어도, 증설 조건 임계를 넘긴 후에 조건 시간을 채우기도 전에 기존 태스크가 뻗어버려서, 증설이 트리거 되지를 못한 것이었다.
위 상황을 관측하고 2가지 조치를 취했다. 부하가 과중되어도 버티게 만드는 것과, 버티는 선 자체를 올리는 조치를 진행했다.
부하가 과중되어도 버티게 만들자 - 부하 차단기 설정
오토스케일 된 태스크 도착전까지 처리량은 보존하면서, 태스크가 죽지 않게 만드려면, 앞단에서 부하를 차단하고 503 Retry를 뱉게 하여 한계점 바로 밑에서 최고 효율로 일하는 환경을 만들어줘야 했다.
OOM으로 죽는 걸 관측했으니, 메모리가 차기 전에 앞단에서 거절하게 만들었다. in-flight 요청 1850개(요청을 너무 많이 들고 있으면 OOM이 났다) & 메모리 85% 임계를 넘으면 요청을 받지 않고 즉시 거절 응답을 주도록 설정했다.
같은 급증을 다시 꽂았다.
| 차단기 전 | 차단기 후 | |
|---|---|---|
| 태스크 사망 | 4회 | 0회 |
| 200 응답 | 15796 | 38762 (약 2.5배) |
| 오토스케일 | 실패 | 성공 |
죽지 않으니 처리량이 오히려 2.5배가 됐고, 태스크가 살아있으니 오토스케일도 정상적으로 떴다. 다만 이 조치가 해결한 건 사망이지 데이터 유실은 아니었다. 급증 구간에서 텔레메트리 유실이 23% 가량 진행되었는데, 차단기는 앞단에서 부하를 막아줬지만 아직 유실이 내부 발송 경로에서 나고 있었다.
버티는 선을 올리자 - L1 캐시
유실을 뜯어보니 최대 유출처는 origin variant 설정 전송이었다. 간단히 말하면 고객사 코드베이스 상의 LLM 호출 설정 정보(모델, 파라미터, 시스템 프롬프트 등) 였는데, 고객사 재배포가 없는한 같은 값일 것이기에 마지막으로 보낸 설정값을 게이트웨이 로컬에 캐싱해둬서, 같으면 발송 자체를 진행하지 않게 변경했다.
당연하게도 이후 같은 테스트에서 origin 발송이 38727건 -> 33건으로 줄었고, 게이트웨이 워커의 부하와 그 전송 데이터를 받는 분석 서버 부하도 같이 줄어들면서 전체 텔레메트리 유실이 23%에서 0.005%로 떨어졌다.
게이트웨이 스펙 확정
목표는 피크 100 rps, 태스크당 안정선은 50 rps. 게이트웨이 태스크 스펙은 0.25 vCPU / 512 MB 2대로 확정했다. 이후 목표 부하 조합 검증에서 2대가 100 rps를 받으며 CPU 70~74.5%로, 빡빡하지만 안정적으로 서빙하는 것을 확인했다. 급증에 대해서는 부하 차단기가 오토스케일이 도착할 시간을 벌어줄 것이다!
게이트웨이는 정리됐다. 그런데 게이트웨이가 받는 트래픽만큼의 이벤트가 분석 서버로 흘러들어온다. 이제 뒷단 모듈을 해결해보자.
분석 서버 Breakpoint Test
게이트웨이와 SDK가 보내는 이벤트를 받아 저장하고 집계하는 서버.
같은 방식으로 event 인입을 계단식으로 올렸다. 원래 예상은 단건 INSERT가 전부 DB로 가니 병목도 DB일 것이라는 쪽이었는데, 첫 결과부터 예상이 깨졌다.
- 0.25 vCPU 기준 태스크당 약 60 rps에서 분석 서버 CPU가 먼저 포화했다. 너무 작은 CPU 자원 할당으로 인해서 이벤트를 처리할 CPU 시간을 기본 서버 구동을 위한 시간과 나눠가져서 자원이 턱없이 부족했다.
- vCPU를 0.25에서 0.5에서 올리고 재관측하니 처리량이 약 5.9배, 0.5에서 1로 올리니 약 1.7배로 뛰었다.
- 그런데 1 vCPU에서는 CPU가 아닌 힙 OOM으로 인한 새로운 죽음이 나왔다. 취약 자원이 CPU에서 힙으로 옮겨갔다.
힙은 왜 터진거지? - 적체 요청당 94 KB
힙이 부족한가 싶어 192 MB에서 512 MB로 키웠는데, 천장이 거의 그대로였다. 크기 문제가 아니라 무언가가 힙을 포화시키고 있었던 건데
이번엔 부하를 천천히 올려서 죽기 직전 상태를 관측했다. 분석 서버가 처음으로 안 죽었고, 1500 rps를 5분간 완주했으며 천장은 1682 rps로 찍혔다. 그리고 그 순간의 적체를 뜯어봤는데 답이 나왔다.
- 적체된 요청 2955건 중 2953건, 99.9%가 DB 커넥션 대기였다.
- 힙 사용량 증가분을 적체 건수로 나누면, 적체 요청 하나가 힙을 94KB씩 물고 있었다.
힙을 물고 있는 이유를 확인해보니 PG의 automatic ANALYZE 때문에 테스트 중 최대 12초 까지 스톨이 생겼고, 그동안 이벤트랑 게이트웨이 텔레메트리가 계속 들어와서 힙에 쌓여서 OOM이 났던 것이었다.
스톨을 버티는 힙 크기 산정
ANALYZE 스톨은 DB에서 일어나는 일이라 분석 서버 쪽에서 없앨 수 있는 게 아니었기에, 분석 서버에선 스톨 동안 죽지 않고 버티는 쪽으로 잡고 그 기준으로 힙 크기를 산정했다.
1
2
3
4
스톨 중 적체 상한값: 태스크당 500 rps * 12초 = 6000건
적체에 의해 차지되는 힙: 6000건 * 94 KB = 564 MB
+ 평시에 물고있는 힙 크기: 195 MB
= 필요분: 759 MB -> 힙 1024 MB (여유 35%)
힙 1024 MB는 태스크 메모리 2 GB 안에 RSS 65%로 들어가서 태스크 스펙은 그대로였다. 힙 크기를 늘려서 스톨에 의한 최대 생존 시간을 확보했다.
분석 서버 스펙 확정
1 vCPU / 2 GB 2대, 힙 1024 MB로 확정했다. 분석 서버의 실제 인입은 event만이 아니라 게이트웨이 텔레메트리까지 합산이라, 검증도 목표 조합인 게이트웨이 100 rps랑 event 1000 rps를 동시에 때렸고, 이 조합에서 분석 서버 스펙이 여유롭게 처리했다.
DB 스펙 확정
게이트웨이와 분석 서버의 부하가 최종적으로 모이는 곳
모듈별 breakpoint는 단독 측정이었기에 마지막으로 목표 부하 조합으로 전체 시스템을 같이 돌려서, 목표 지점에서 안정적으로 서빙되는 것을 확인했다.
게이트웨이 100 rps + event 1000 rps를 12분간 유실 0, 사망 0, 부하 차단 0으로 완주했고, 이후 같은 조합을 40분까지 유지 완주하는 것도 확인했다. 일단 앞단 모듈에선 목표 달성 완료
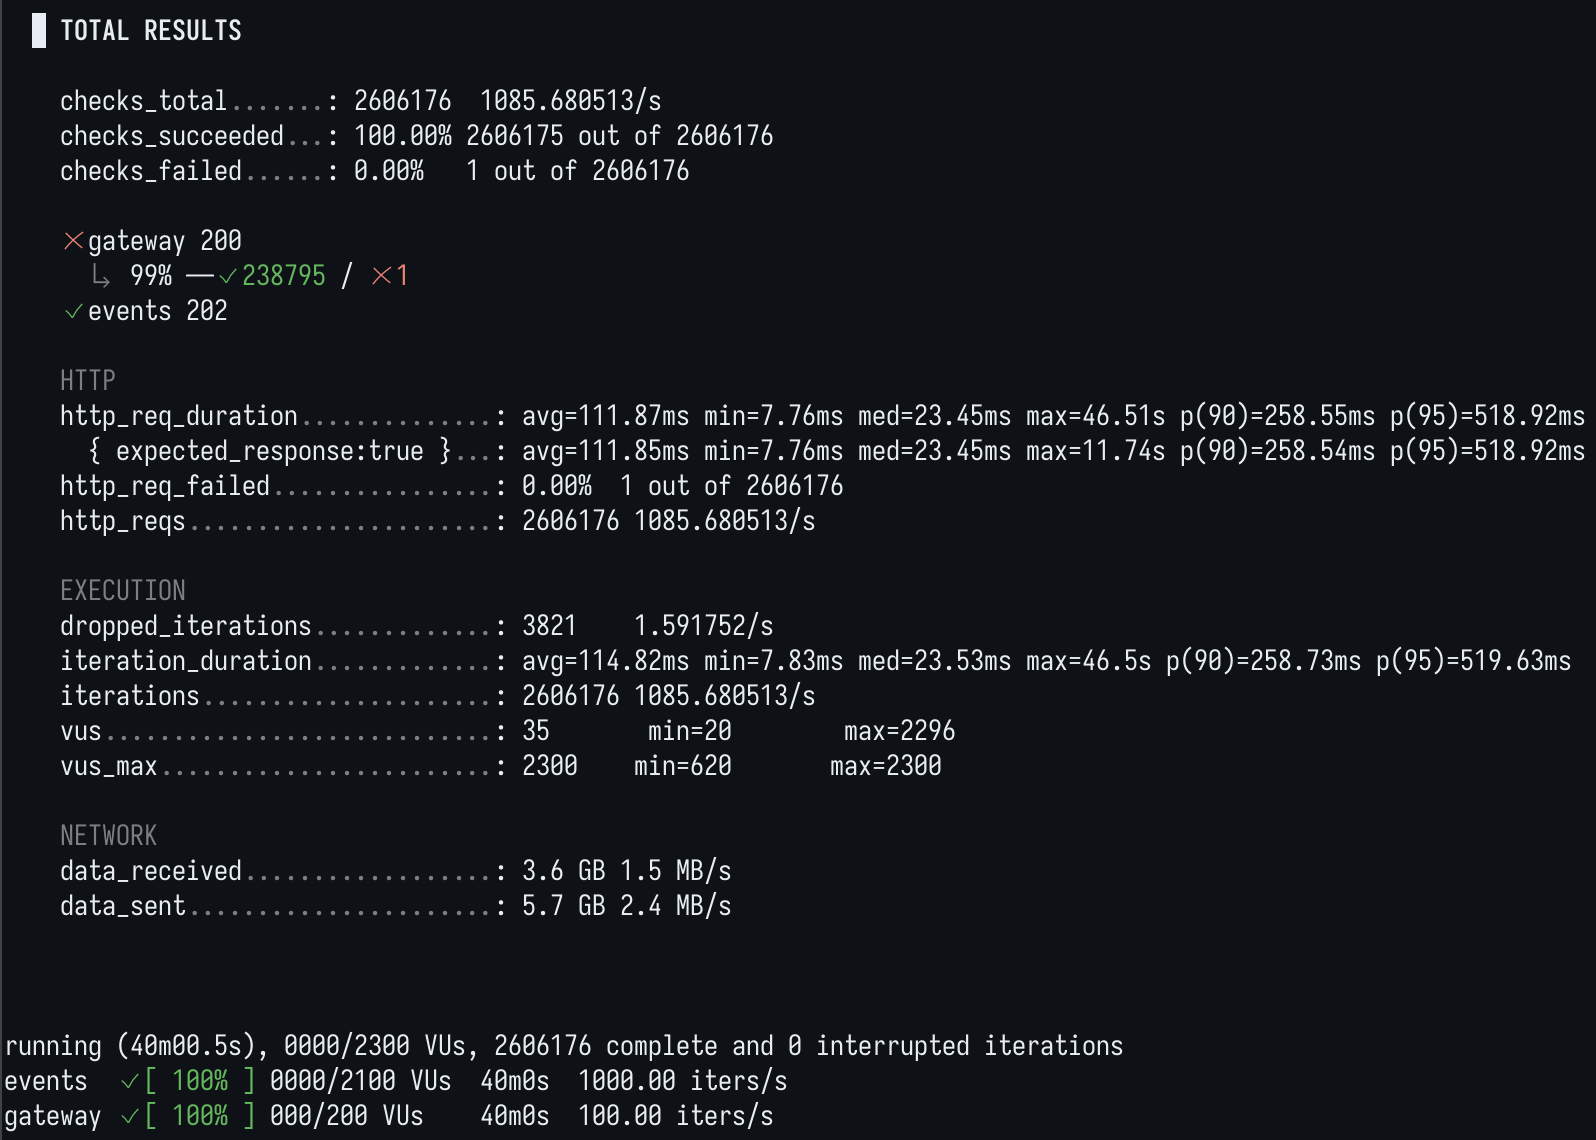
다만 가장 뒷단의 DB는 목표 조합을 20~50분 걸어두면 RDS가 메모리 부족 판정으로 shared_buffers를 강제로 깎으면서 무너지는게 관측되었다. micro의 1GB는 RDS 에이전트 몫 420 MB를 빼면 PostgreSQL에 할당되는게 600 MB뿐이었고, ANALYZE 스톨의 원인도 결국 이 메모리 부족이었다. 그래서 한 단계 위인 db.t4g.small(2 GB)을 하한으로 스펙을 확정했다.
추가로 인입 write와 집계 read의 경합을 피하기 위해 Read Replica를 분리했다. 인입 중에 리플리카로 집계를 돌려도 소스 DB는 영향이 없도록 분리를 진행했다.
최종 인프라 스펙
| 모듈 | 확정 스펙 |
|---|---|
| 게이트웨이 | Fargate 0.25 vCPU / 512 MB x 2대 + 문전 차단 + 오토스케일 |
| 분석 서버 | Fargate 1 vCPU / 2 GB x 2대 + 오토스케일 |
| DB | RDS db.t4g.small (2 GB) + 리드 리플리카 db.t4g.micro (1 GB) |
마치며
다회차의 부하 테스트를 통해, 각 모듈이 어디서 무너지고 부하가 어떤 자원을 소모하는지 몸소 겪을 수 있었다. 다만 아직도 분석 서버 부하 차단이나 추가적인 캐싱 등 내부적으로 개선할 여지는 많이 남아있다고 생각하기에, 인프라 비용 감축을 위해 조금 더 파볼 예정이다.