전환율 계산 쿼리 개선기
먼저 Analytics 서비스 특성 상, 전환율을 계산해주는 로직이 필요하다. 분자/분모 형태로, 앞단 이벤트를 겪은 전체 인원을 분모로, 그중에서 뒷단 이벤트를 발생시킨 인원을 분자로 둔다.
여기서 앞단 이벤트는 LLM의 응답 데이터를 관측한 인원이고, 뒷단 이벤트는 유저가 브라우저나 앱에서 발생시킨 특정한 이벤트 데이터이다. 전체 LLM 응답을 받은 인원 중에서, 그 이벤트를 추가 발생 시킨 비율을 보는 것이다.
여기서 유저 데이터와 LLM 응답에 노출된 기록을 연결해줘야 한다. 시간축으로 앞선 노출에 유저 이벤트를 귀인하는 시스템을 구축해야했다!
용어
- exposure: LLM 응답에 노출된 기록. 어떤 모델+파라미터의 응답이었는지를 포함하는 데이터.
- event: 유저 이벤트.
- variant: {모델, 파라미터, 시스템 프롬프트}의 집합으로서, 호출을 태우는 실험군 개념. 모델 간 AB Testing이 핵심 가치인 우리 서비스 특성상 모델별 성과를 비교하여 측정하는 것이 중요하다.
exposure은 하위에 variant 설정 정보를 가진다. 해당 노출이 어떤 모델/파라미터의 응답이었는지가 기록되었다는 것.
무엇을 계산하나
내부 로직은 크게 둘로 나뉜다.
/series: 전체 시스템에서의 통합적인 전환율을 집계하는 로직/series/by-variant: 특정한 모델(실험군)별로 각각의 성과를 집계하는 로직
집계하는 기간의 범위는 24h/7d/30d이고 트렌드 그래프 시각화를 위해 각 기간을 1h/6h/1d의 버킷으로 나누어 각 버킷에 대한 개별 집계도 진행한다.
글로만 보면 추상적이니, 기능적으로는 아래 화면을 구성하기 위한 데이터를 도출하는 로직이라고 생각하면 된다.
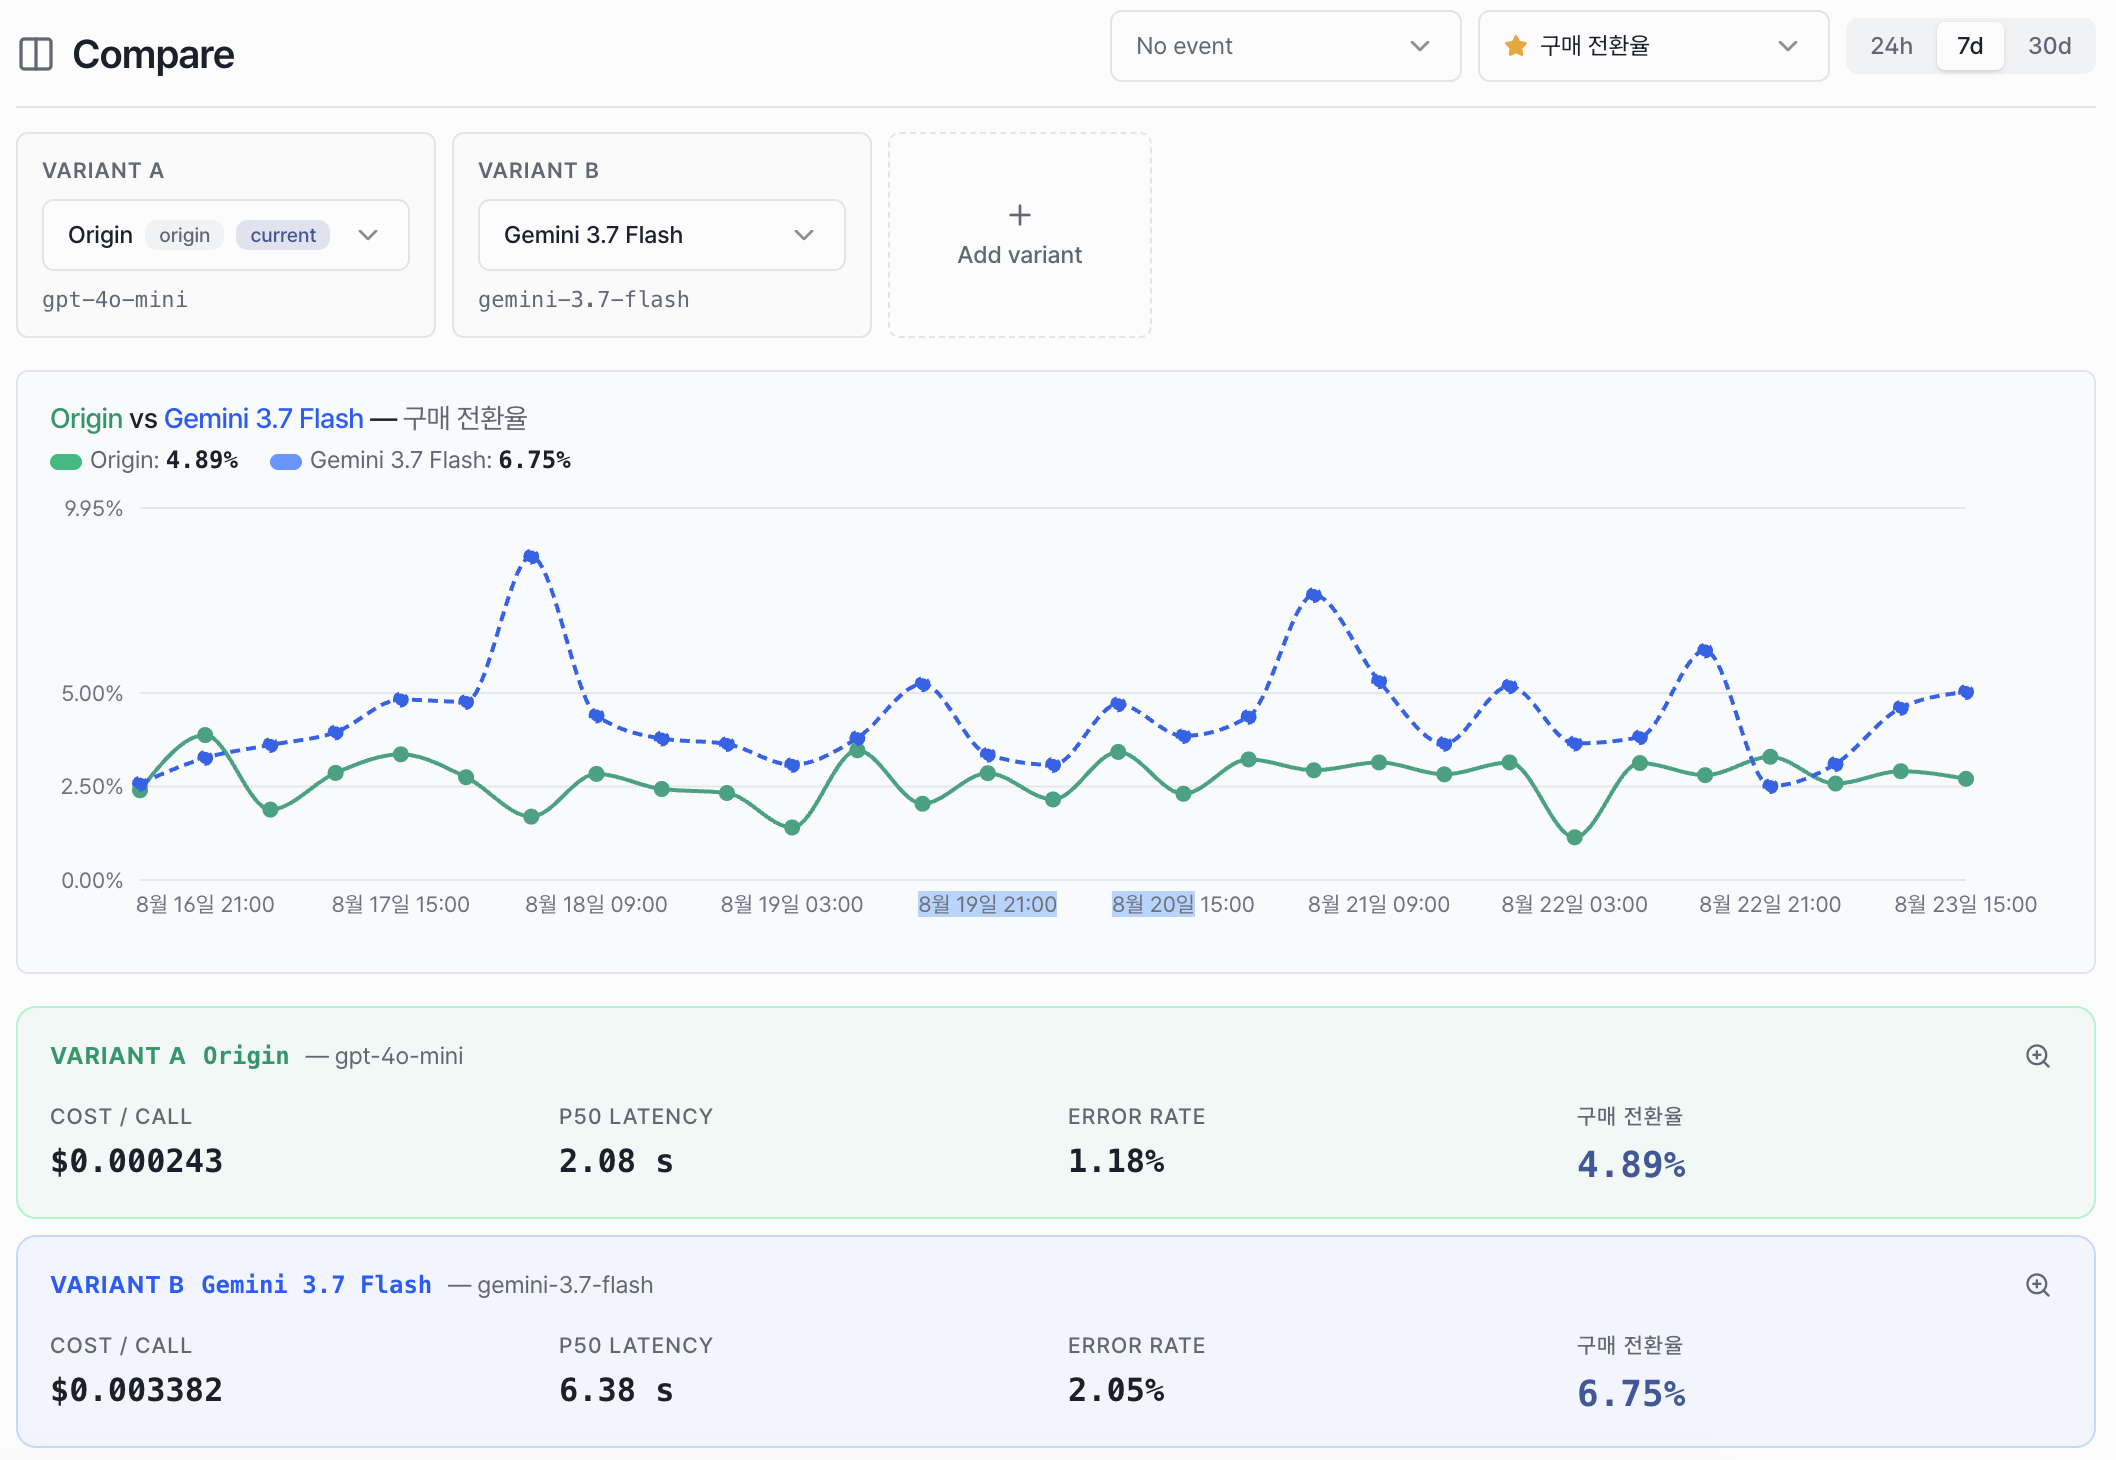
쿼리 튜닝 자체는 7d 기준으로 실행 및 측정을 진행하였다.
위 목적에 따른 쿼리 작성과, 성능 문제로 인한 튜닝 이야기를 해보려한다.
측정 환경 및 데이터셋
- PostgreSQL 18.4
- LLM 응답 노출 기록: exposure 83.5만 행
- 유저 이벤트 데이터: event 523만 행
- 30일치 데이터에 조회 창은 7일로 잡았다.
- 7일 조회 창 + 특정 project·node(event는 event_name) 조건까지 걸면 실제 스캔 대상은 exposure 3.2만 행, event 6.1만 행
- device_id는 user와 대응된다. device_id의 개수가 인원 수와 동치라고 생각하면 된다!
/series - 전환율은 어떻게 계산되나
LLM 응답에 노출된 사용자 중 특정 이벤트를 남긴 비율을 설정 기간 전체에 대한 값 하나와 버킷별 시계열 데이터로 뱉는다.
전체 기간
먼저 전체 기간에서의 분모를 구하는 쿼리는 아래와 같다. 기간 내에서 LLM 응답을 받은 device_id의 distinct를 센다.
1
2
3
select count(distinct device_id) from exposure
where project_id = '11111111-1111-1111-1111-111111111111' and node_key = 'support.chat.answer'
  and occurred_at >= '2026-07-26 00:00:00+00' and occurred_at < '2026-08-02 00:00:00+00'
분자는 분모의 부분집합이여야 하기에, 기간 내에 앞선 exposure이 존재하면서도, event를 발생시킨 device_id를 집계하여야 100%를 초과하는 불상사가 발생하지 않고 정확한 “전환율”이 나온다!
물론 이 경우 윈도우 내에 exposure이 존재하지 않는, 시간축에서 오래된 exposure의 영향을 받은 event는 집계되지 않는다는 문제가 있다. 다만 무결성이 더 중요하기에 구조적으로 택한 결정이다.
1
2
3
4
5
6
7
select count(distinct b.device_id) from event b
where b.project_id = '11111111-1111-1111-1111-111111111111' and b.event_name = 'ticket_resolved'
  and b.occurred_at >= '2026-07-26 00:00:00+00' and b.occurred_at < '2026-08-02 00:00:00+00'
  and exists (select 1 from exposure e
              where e.project_id = b.project_id and e.device_id = b.device_id
                and e.node_key = 'support.chat.answer'
                and e.occurred_at >= '2026-07-26 00:00:00+00' and e.occurred_at <= b.occurred_at)
버킷별
이번엔 버킷별로 분모를 구해보자면 아래와 같다. PG의 date_bin을 통해 6시간 간격의 시각들에 각각의 exposure 데이터를 group으로 묶는다.
1
2
3
4
5
select date_bin('6 hours', occurred_at, timestamptz '1970-01-01 00:00:00+00') as t,
       count(distinct device_id) from exposure
where project_id = '11111111-1111-1111-1111-111111111111' and node_key = 'support.chat.answer'
  and occurred_at >= '2026-07-26 00:00:00+00' and occurred_at < '2026-08-02 00:00:00+00'
group by 1
버킷별 분자는 어떨까? 결국 전체 기간에서 적용한 방식의 연장선이다. EXISTS를 통해 버킷내에 exposure이 존재하는, event의 device_id 개수를 집계한다.
다만 맨 앞 버킷은 전체 조회 창의 시작 시간으로 맞춰주어야 전체 기간을 벗어난 데이터가 포함되지 않는다.
1
2
3
4
5
6
7
8
9
10
select date_bin('6 hours', b.occurred_at, timestamptz '1970-01-01 00:00:00+00') as t,
       count(distinct b.device_id) from event b
where b.project_id = '11111111-1111-1111-1111-111111111111' and b.event_name = 'ticket_resolved'
  and b.occurred_at >= '2026-07-26 00:00:00+00' and b.occurred_at < '2026-08-02 00:00:00+00'
  and exists (select 1 from exposure e
              where e.project_id = b.project_id and e.device_id = b.device_id
                and e.node_key = 'support.chat.answer'
                and e.occurred_at >= greatest(date_bin('6 hours', b.occurred_at, timestamptz '1970-01-01 00:00:00+00'), '2026-07-26 00:00:00+00')
                and e.occurred_at <= b.occurred_at)
group by 1
측정 결과
결과적으로 실 측정에서 상단 쿼리는 다 빨랐다.
| 쿼리 | median |
|---|---|
| 전체 기간 (EXISTS) | 210 ms |
| 버킷별 (EXISTS) | 107 ms |
EXISTS는 있냐/없냐 만 확인하기에 옵티마이저가 Hash Semi Join을 통해 다음처럼 처리가 가능하다. exposure 슬라이스를 한 번 훑어 해시를 만들고, 이벤트 별로 해시를 때리면 끝이기 때문에 빠른 처리가 가능하다.
문제의 by-variant, 즉 event를 가장 최근의 variant에 붙여야하는 경우, 조회 창안에 exposure가 있는지만 체크하면 되는게 아니라, 그중에서 어떤 exposure가 최근인지를 확인하고, 그 exposure에 설정된 variant에 event의 성과를 귀속 시켜야 한다.
쿼리가 어떻게 달라졌는지, 왜 개선이 필요했는지 확인해보자.
/series/by-variant - 같은 질문을 variant 별로
위에서 설명한 로직을 A/B 실험군(variant)별로 쪼개서 전환율을 비교하도록 만들어야 한다.
앞서 이야기 했듯이 /series 는 직전 노출이 있었나만 확인하면 됐지만, 여기서는 각 이벤트를 어느 variant 에 귀속시킬지를 정해야 한다. 규칙은 event 발생 시각 기준으로 가장 최근의 exposure를 찾아서, 그 exposure의 variant의 성과에 event를 포함시키는 것.
“가장 최근 한 건”이라는 것을 SQL로 직역하면 LATERAL 이 나온다. 이벤트마다 그 사용자의 선행 exposure을 시간 역순으로 정렬해서 첫 행을 뽑는 것. 처음 작성한 쿼리가 정확히 요 모양이었다.
분모는 variant로 그룹핑을 해서, exposure에 속한 device_id의 distinct를 세는데, 분자 구하는 식이 더 중요해서 일단 생략한다.
전체 기간
전체 기간에 대한 분자 구하는 식은 아래와 같다.
1
2
3
4
5
6
7
8
9
10
select attr.variant_id, count(distinct b.device_id)
from event b
cross join lateral (select e.variant_id from exposure e
                    where e.project_id = b.project_id and e.device_id = b.device_id
                      and e.node_key = 'support.chat.answer'
                      and e.occurred_at >= '2026-07-26 00:00:00+00' and e.occurred_at <= b.occurred_at
                    order by e.occurred_at desc, e.id desc limit 1) attr
where b.project_id = '11111111-1111-1111-1111-111111111111' and b.event_name = 'ticket_resolved'
  and b.occurred_at >= '2026-07-26 00:00:00+00' and b.occurred_at < '2026-08-02 00:00:00+00'
group by 1
버킷별
버킷별 식도 아까처럼 date_bin에 따른 그룹핑을 사용한다.
1
2
3
4
5
6
7
8
9
10
11
12
13
select attr.variant_id,
       date_bin('6 hours', b.occurred_at, timestamptz '1970-01-01 00:00:00+00') as t,
       count(distinct b.device_id)
from event b
cross join lateral (select e.variant_id from exposure e
                    where e.project_id = b.project_id and e.device_id = b.device_id
                      and e.node_key = 'support.chat.answer'
                      and e.occurred_at >= greatest(date_bin('6 hours', b.occurred_at, timestamptz '1970-01-01 00:00:00+00'), '2026-07-26 00:00:00+00')
                      and e.occurred_at <= b.occurred_at
                    order by e.occurred_at desc, e.id desc limit 1) attr
where b.project_id = '11111111-1111-1111-1111-111111111111' and b.event_name = 'ticket_resolved'
  and b.occurred_at >= '2026-07-26 00:00:00+00' and b.occurred_at < '2026-08-02 00:00:00+00'
group by 1, 2
측정 결과
로직으로는 귀속 규칙의 직역이라 결과도 정확했는데 문제는 실측된 집계 시간이었다..
| 쿼리 | median |
|---|---|
| 전체 기간 (LATERAL) | 21124.0 ms |
| 버킷별 (LATERAL) | 1160.2 ms |
/series 의 분자와 같은 테이블 & 같은 창을 읽는데 100배가 느렸다. EXPLAIN에서 이유가 나왔다.
1
2
3
4
5
6
7
8
9
10
11
12
Nested Loop  (actual time=44.645..21036.816 rows=29233 loops=1)
  -> Index Scan using ix_event_catalog on event b  (actual time=0.165..70.735 rows=60708 loops=1)
  -> Memoize  (actual time=0.345..0.345 rows=0.48 loops=60708)
       Cache Key: b.project_id, b.device_id, b.occurred_at
       Hits: 0  Misses: 60708  Evictions: 15983  Memory Usage: 8193kB
       -> Limit  (rows=0.48 loops=60708)
          -> Sort  (rows=0.48 loops=60708)
               Sort Key: e.occurred_at DESC, e.id DESC
               -> Bitmap Heap Scan on exposure e  (actual time=0.343..0.344 rows=5.10 loops=60708)
                    -> Bitmap Index Scan on ix_exposure_node_time  (actual time=0.305..0.305 rows=15972.12 loops=60708)
                         Index Cond: (project_id = b.project_id AND node_key = '...' AND occurred_at >= '2026-07-26' AND occurred_at <= b.occurred_at)
Execution Time: 21124.014 ms
읽는 순서대로 보면 이렇다.
Nested Loop가 21037ms 인데 바깥쪽 eventIndex Scan은 71ms 만에 끝났다. 나머지 21초는 전부 안쪽이다.- 안쪽은
Memoize부터 전부loops=60708, 즉 조회 창 안의 event 건수만큼 반복 실행됐다.Sort Key … DESC+Limit이order by … limit 1의 흔적이고, Index Cond 에b.device_id,b.occurred_at이 박혀 있는 게 바깥 행에 의존하는 LATERAL 이다. Memoize는 옵티마이저가 반복을 줄여보려고 붙인 캐시인데, 키에b.occurred_at이 들어가서 이벤트마다 키가 달라Hits: 0. 아무것도 못 했다.- 맨 아래
Bitmap Index Scan이 1회 0.305ms 에 15972행을 읽는다. 인덱스에 device_id 가 없어서 7일치 exposure 를 기간으로만 긁고, 위Bitmap Heap Scan에서 실제로 쓰는 건 5.1행이다. 0.305ms × 60708 = 18.5초, 전체의 88%가 이 한 줄이다.
같은 플랜을 explain.dalibo.com 에 넣으면 노드별 실제 소요 시간(loops 곱한 값)이 표로 나온다.
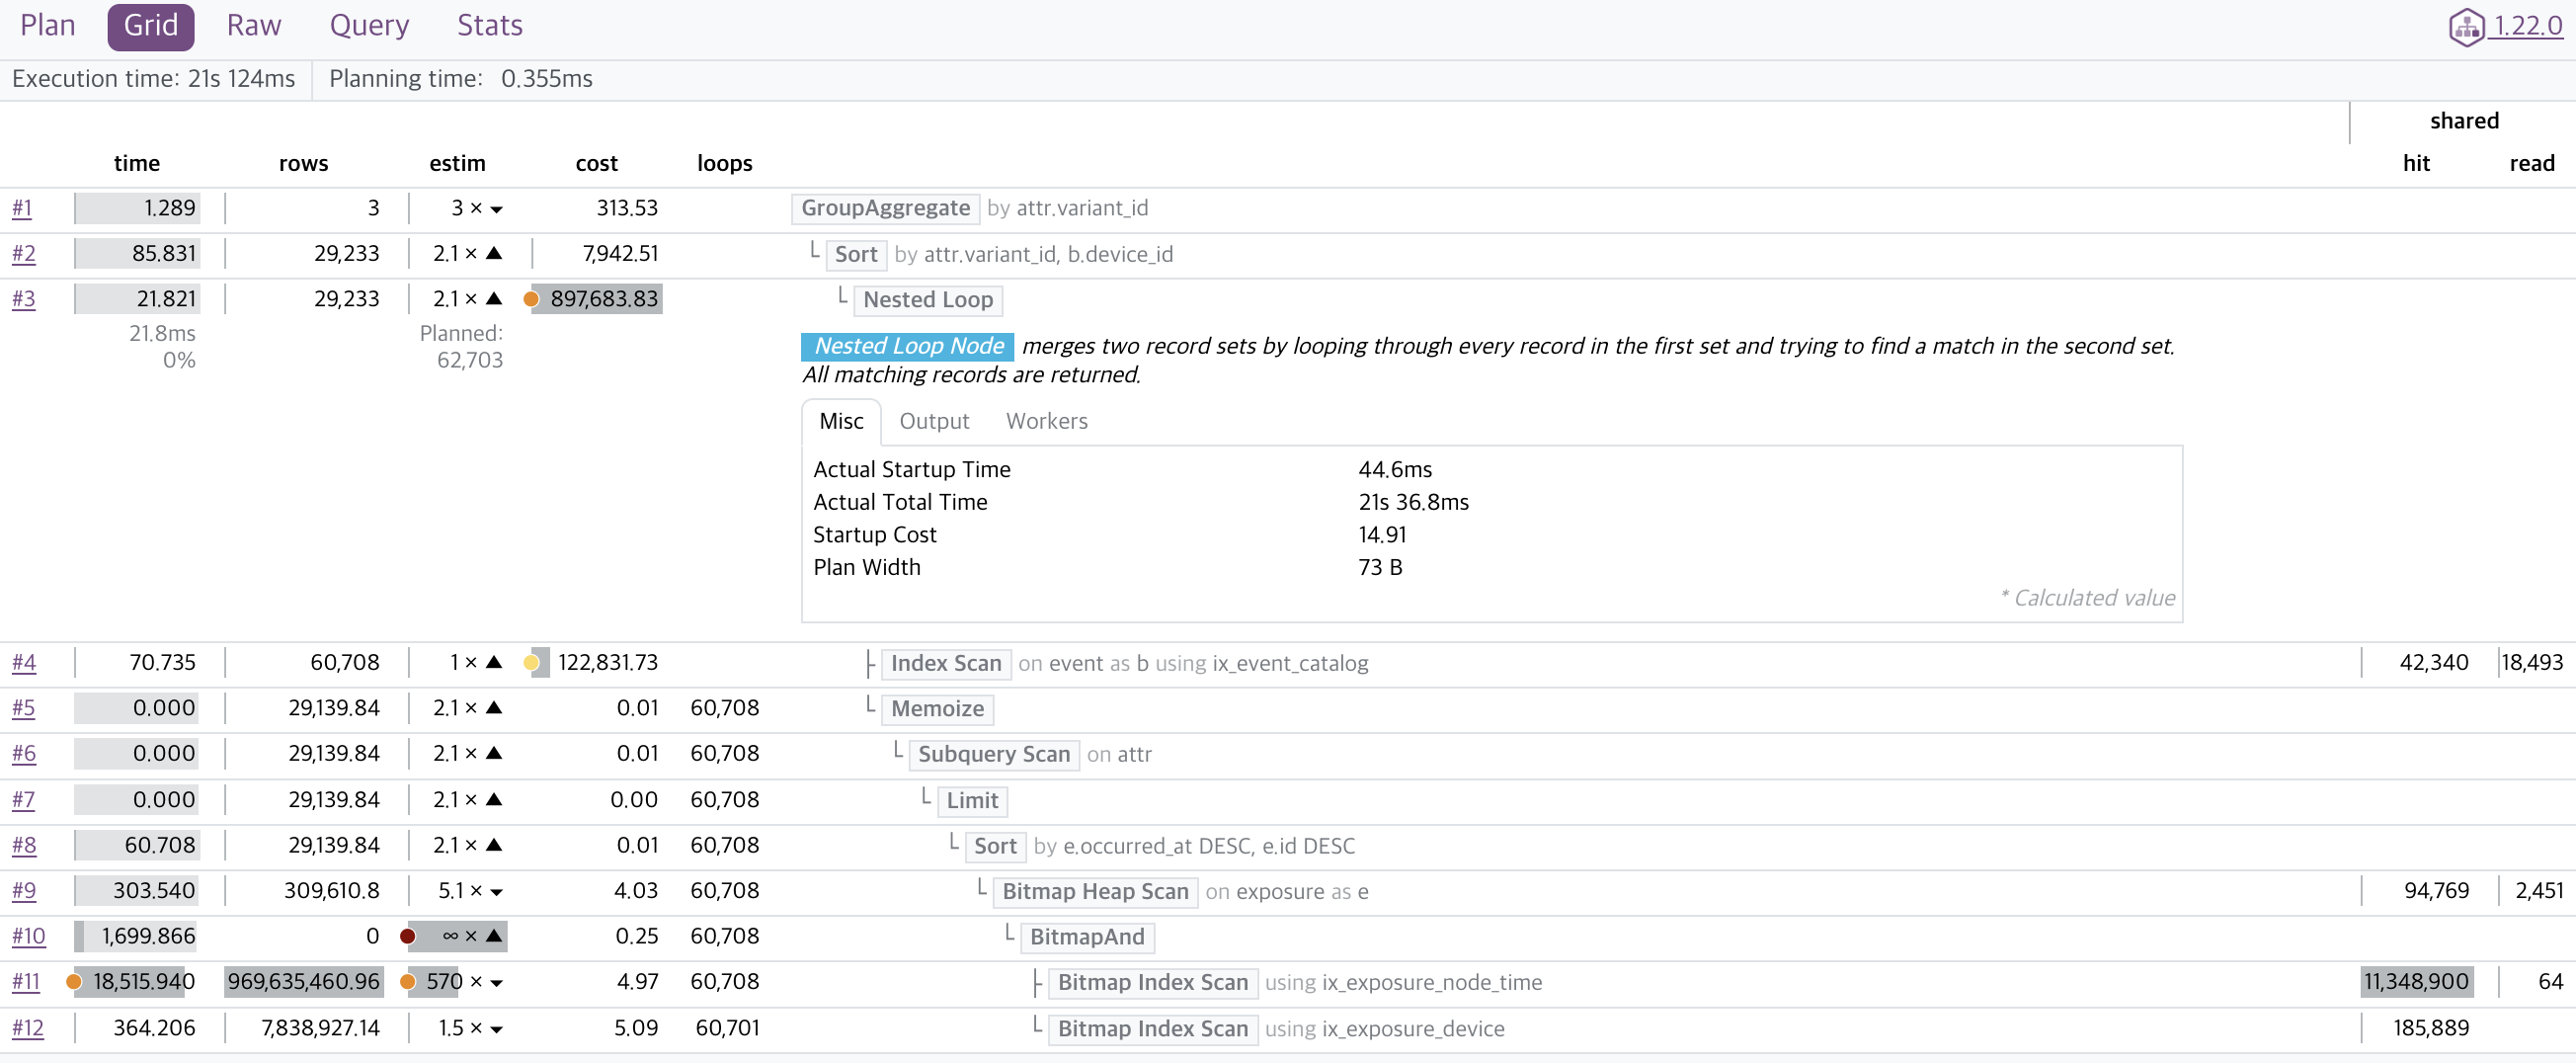
order by … limit 1이 붙은 LATERAL은 옵티마이저가 조인으로 못 풀어낸다.- EXISTS 는 세미조인으로 풀었지만, “가장 최근 한 건” 은 그 변환이 성립하지 않아서 이벤트 건별로 실행이 강제됐다.
- 그 결과 이벤트 1건의 직전 노출 1건을 찾으려고 7일치 exposure 범위만큼 훑는 일을 event 개수만큼 반복했다.
event과 exposure 개수가 각각 10배 늘면 집계 시간이 100배가 늘어나는 비선형적인 상황이 생겼고, 이건 직접적인 쿼리 재작성이 필요했다.
쿼리 두 개를 하나로 - 조인 + row_number()
건별 실행을 없애보자. “가장 최근 한 건” 을 건별 limit 1 대신 집합 연산의 순위 매기기로 바꿔서, 조인으로 (이벤트 * 선행 노출) 후보를 다 만들고, row_number() 로 이벤트마다 1등만 남기면 전체 기간과 버킷별 집계가 한 쿼리에서 같이 나온다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
with attributed as (
  select b.device_id, b.occurred_at as ets,
         e.variant_id as v, e.occurred_at as ats,
         row_number() over (partition by b.device_id, b.id
                            order by e.occurred_at desc, e.id desc) as rn
  from event b
  join exposure e
    on  e.project_id = b.project_id and e.device_id = b.device_id
    and e.node_key = 'support.chat.answer'
    and e.occurred_at >= '2026-07-26 00:00:00+00' and e.occurred_at <= b.occurred_at
  where b.project_id = '11111111-1111-1111-1111-111111111111' and b.event_name = 'ticket_resolved'
    and b.occurred_at >= '2026-07-26 00:00:00+00' and b.occurred_at < '2026-08-02 00:00:00+00'
), one as (select * from attributed where rn = 1)

select v, null::timestamptz as t, count(distinct device_id)
from one group by 1

union all

select v, date_bin('6 hours', ets, timestamptz '1970-01-01 00:00:00+00') as t, count(distinct device_id)
from one
where ats >= greatest(date_bin('6 hours', ets, timestamptz '1970-01-01 00:00:00+00'), '2026-07-26 00:00:00+00')
group by 1, 2
t is null 인 행이 전체 기간 값이고, 나머지가 버킷별 값이다.
개선 후 EXPLAIN은 이렇다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
Append  (actual time=375.152..383.952 rows=73 loops=1)
  CTE one
    -> WindowAgg  (actual time=182.630..323.321 rows=29233 loops=1)
         Run Condition: (row_number() OVER w1 <= 1)
         -> Gather Merge  (rows=309429 loops=1)  Workers Launched: 2
              -> Incremental Sort  (rows=103143 loops=3)
                   Sort Key: b.device_id, b.id, e.occurred_at DESC, e.id DESC
                   -> Merge Join  (actual time=172.716..196.619 rows=103143 loops=3)
                        Merge Cond: (b.device_id = e.device_id)
                        -> Parallel Bitmap Heap Scan on event b  (rows=20236 loops=3)
                             -> Bitmap Index Scan on ix_event_catalog  (rows=60708 loops=1)
                        -> Sort  (rows=32025 loops=3)
                             -> Bitmap Heap Scan on exposure e  (rows=32025 loops=3)
                                  -> Bitmap Index Scan on ix_exposure_node_time  (rows=32025 loops=3)
  -> GroupAggregate  (rows=3 loops=1)    -- 전체 기간
  -> GroupAggregate  (rows=70 loops=1)   -- 버킷별
Execution Time: 384.454 ms
Nested Loop와Memoize가 사라지고Merge Join이 됐다. event 와 exposure 를 각각 한 번 읽어서(loops=3은 병렬 워커 2개 + 리더 프로세스 1개) device_id 순으로 정렬해 맞붙인다.ix_exposure_node_time스캔이rows=32025 loops=3— 7일치 exposure 를 딱 한 번 읽는다. LATERAL에서는 같은 인덱스를 약 6만 번 × 16000행 읽었다..order by ... limit 1은WindowAgg의Run Condition: row_number() <= 1로 번역됐다. 조인 결과 309429쌍 중 이벤트당 1등만 남겨 29233행이 됐다- 맨 아래
GroupAggregate두 개가union all의 두 가지 — 같은 CTEone을 두 번 읽어 전체 기간과 버킷별 집계를 각각 도출했다.
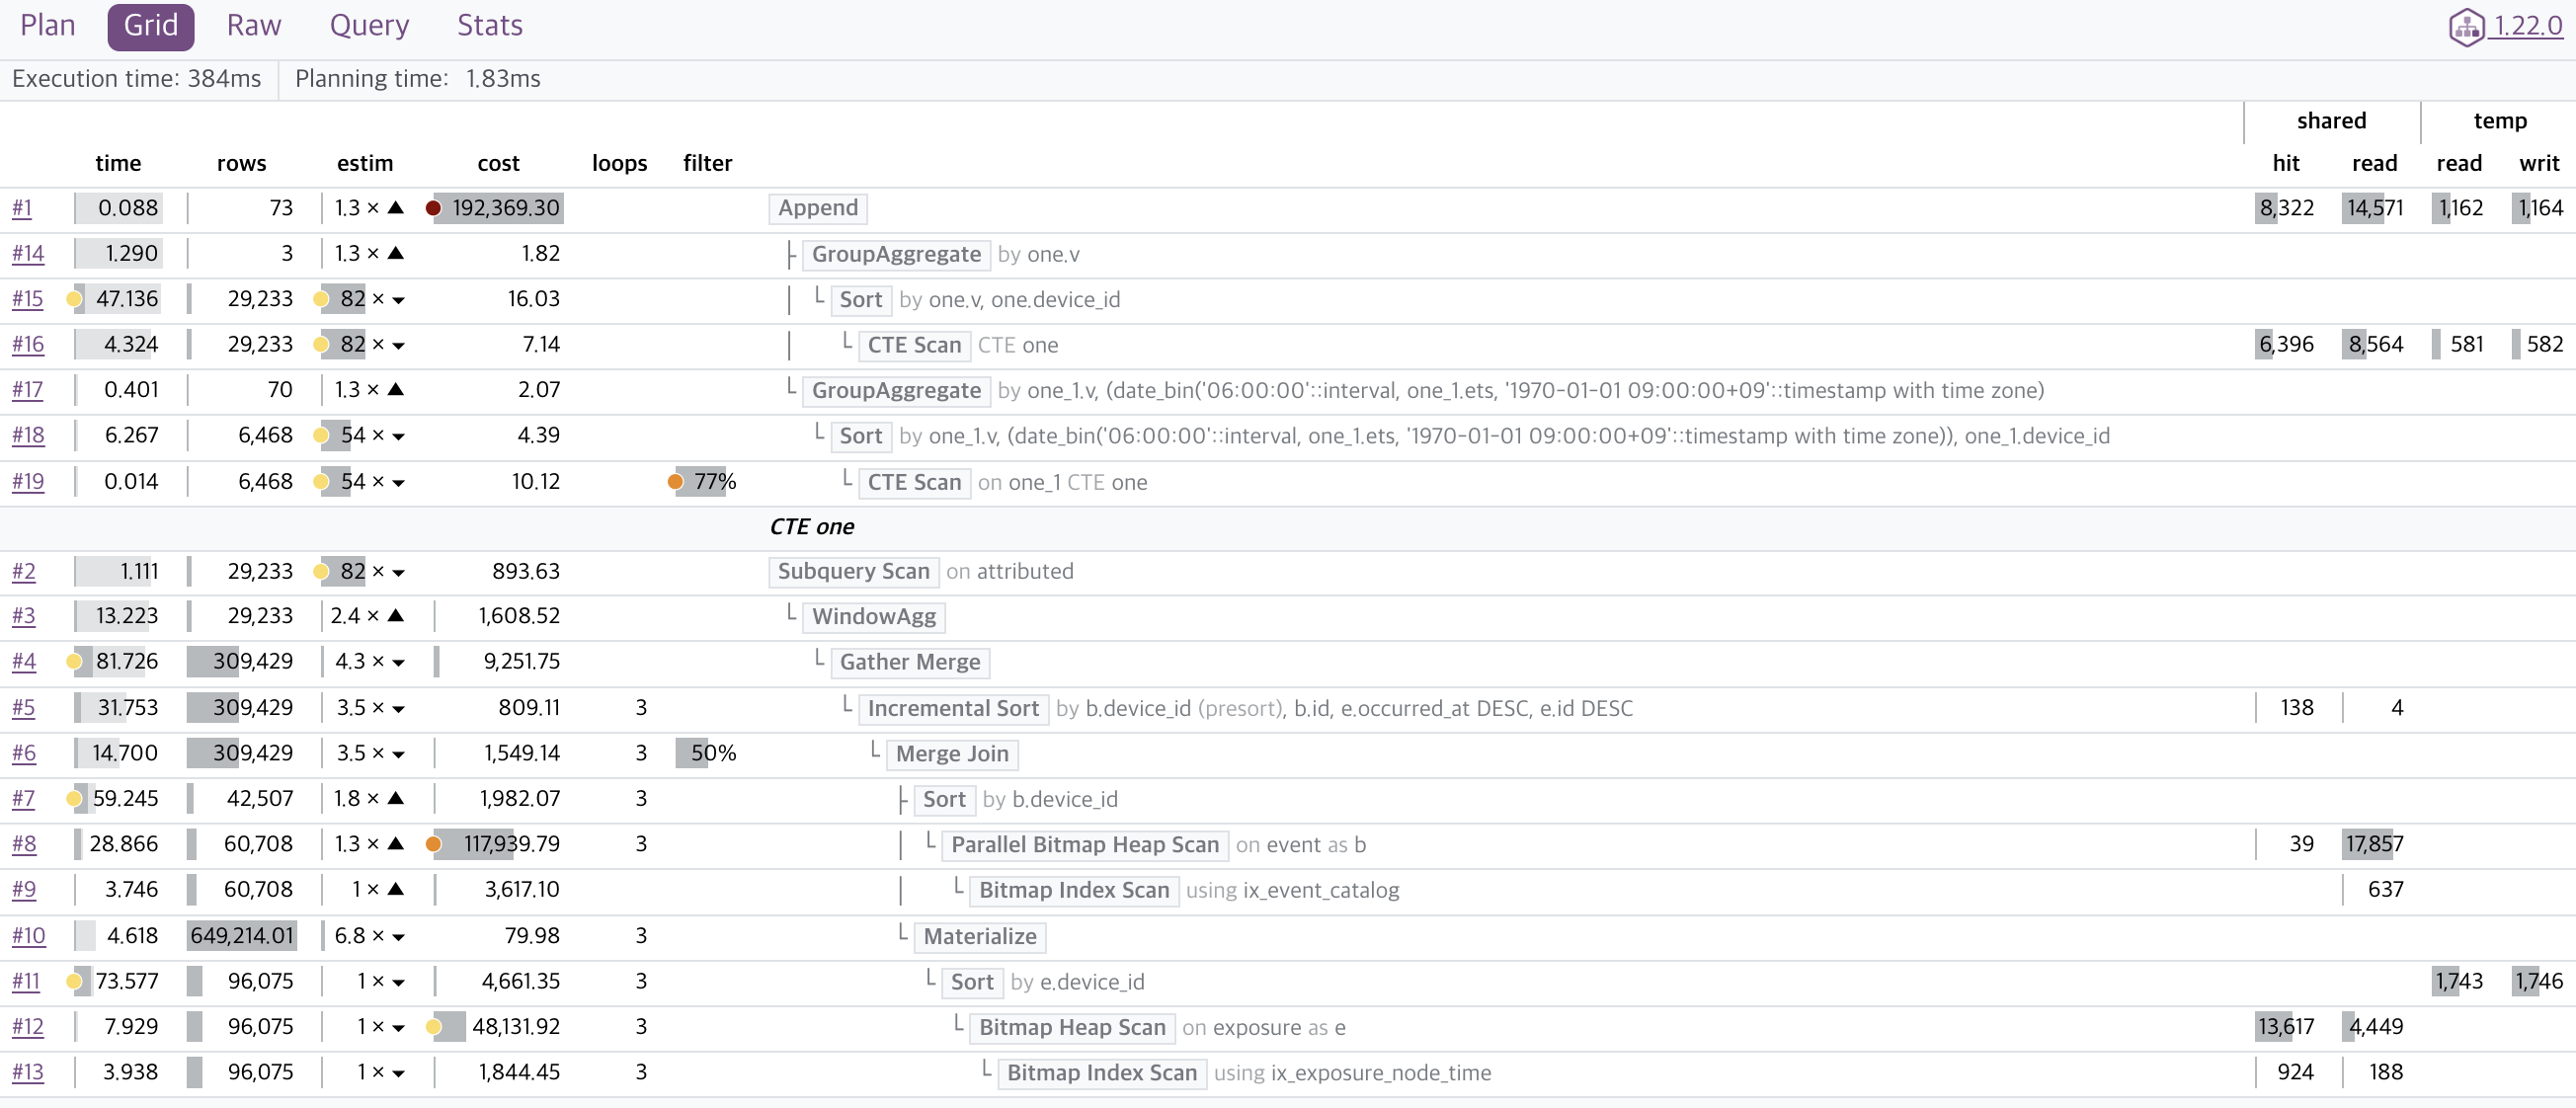
시간이 한 노드에 몰리지 않고 정렬 세 번에 고르게 퍼져 있고, 가장 무거운 exposure 정렬이 74ms 밖에 소모되지 않는다!
측정 결과
| 전 (LATERAL 2쿼리) | 후 (조인+row_number 1쿼리) | |
|---|---|---|
| 시간 | 21124.0 + 1160.2 ms | 384.5 ms (약 1/58) |
이로 인해 event와 exposure를 각각 한 번 읽는 스캔+정렬로 동일한 로직이 수행되고, 데이터 크기에 선형에 가깝게 실행 시간이 찍히도록 개선되었다.
한계
- 일단 선형적인 시간 증가로 돌려는 놓았지만, 기본적으로 서비스에서 event와 exposure이 쌓일수록 집계 쿼리가 느려진다.
- event 인입 시 exposure를 배정해두는 방법이 확실한 방법이겠지만, write 시간을 늘려서 조회를 빠르게 하는 트레이드 오프 관계이기에 실제 운영에서 관측되는 병목에 따라 조절하려고 생각중이다.